
TECHNICAL RECORD / 2026年秋〜11月6日
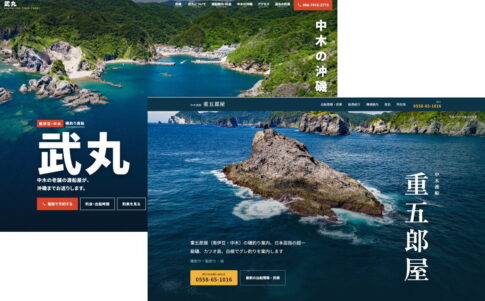
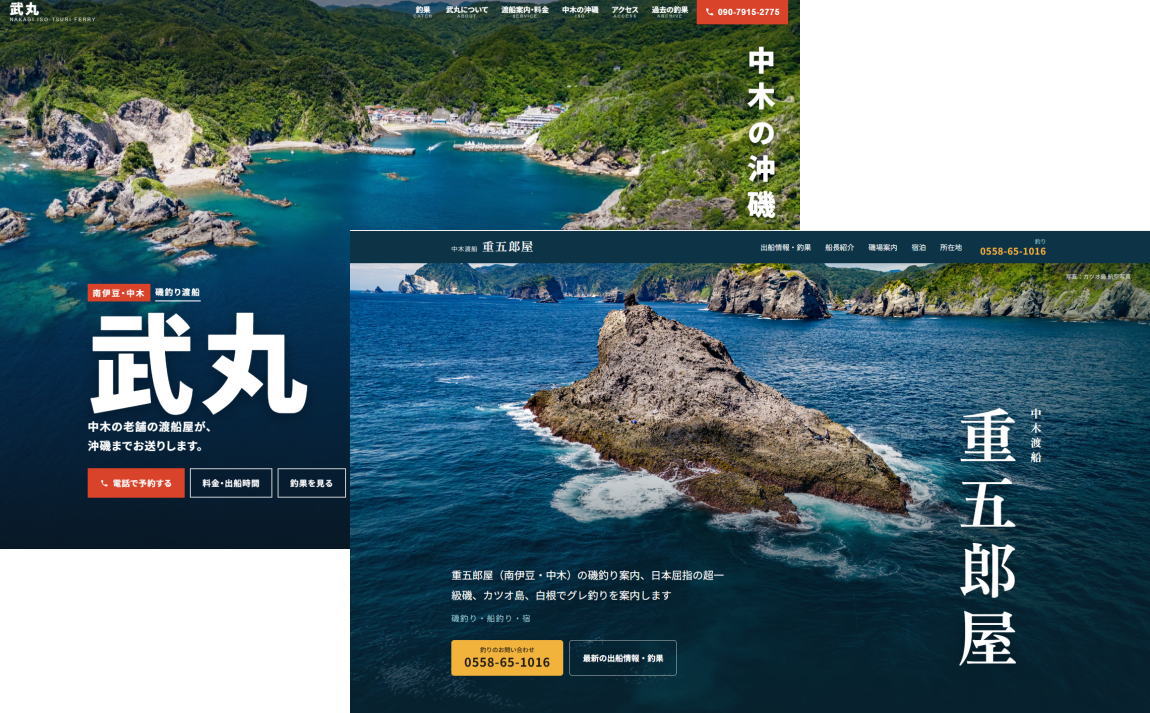
南伊豆・中木の渡船「重五郎屋」と「武丸」のWebサイトを、古い実装から再構築した記録です。対象読者は、PHP・WordPress・HTTP・API・静的サイトの構造が分かる技術者と、数年後にこれを読み返す筆者自身です。うまくいった話だけでなく、遠回り、AIの誤判断、人間が下した判断も、記録に残っている範囲でそのまま書きます。
hirizo.sakura.ne.jp/公開ドメイン nakagi.net/usr/local/bin/php)、MySQL 5.5、Apache(.htaccess 有効)/j568/ 静的HTML+Ameblo RSS → PHP → JSON(CRON 毎時5分)/takemaru/ WordPress 6.8系(記事1,326件)→ 静的HTML+Instagram Graph API → PHP → JSON(CRON 毎時23分・33分)序110バイトの謎
本番公開の直後、追加改修の差分を上書きする前の確認として、サーバー上の top.js のサイズを手順書の値と照らし合わせた。手順書が求めていた値は6,898バイト。FFFTPの一覧にも6,898バイトと表示されていた。ところが、念のためPCにダウンロードしたファイルは7,008バイトだった。
top.js

サーバー側:6,898バイト
PC側:      7,008バイト
差は110バイト。誰かが本番のファイルを書き換えたのか、それとも別の版が混ざったのか。サーバー上で誰かがファイルを直接編集した可能性を疑うべき状況である。
答えは、ファイルの中身ではなく転送経路にあった。Claudeが納品した top.js は、LF改行で110行ある。FTPのテキスト(ASCII)モードでダウンロードすると、各行のLFがCRLFに変換され、1行につき1バイトずつ増える。6,898 + 110 = 7,008。FFFTPをバイナリモードに切り替えて取得し直すと、サイズは一致した。
教訓
「サイズで同一性を確認する」という手順は、転送モードを固定して初めて成り立つ。以後、バックアップと差分のアップロードはすべてバイナリモードで行うことにした。
この記録は、こうした小さな食い違いを一つずつ潰しながら、二つの古いWebサイトを作り直した過程の実録である。
01二つのサイト、二つの技術的負債
同じ南伊豆・中木の渡船サイトでも、二つのサイトが抱えていた問題は性質がまったく違った。
重五郎屋:時間が止まった静的HTML
旧サイトは古い作り方の静的HTMLだった。固定幅830pxのレイアウト、TABLEによる段組み、GIF画像、<font>タグ、インライン属性。船長の紹介、写真、連絡先、ブログ、Facebook、アクセスマップといった情報は揃っていたが、スマートフォンでの閲覧を前提としない設計だった。
武丸:役目を終えつつあったWordPress
| 項目 | 内容 |
|---|---|
| CMS | WordPress 6.8系(調査時は6.8.12)、テーマ Simplicity2 |
| 実行環境 | PHP 7.4.33、MySQL 5.5 |
| 公開記事 | 1,326件 |
| メディア添付のDBエントリー | 約2,043件 |
| 固定ページ | 5件(ご挨拶・サービス案内・アクセス・全沖磯航空写真・沖磯航空写真) |
武丸の問題は、デザインの古さではなかった。10年近く積み重ねた釣果記事、画像、パーマリンク、検索エンジンからの流入を、どうやって壊さずに残すか。課題の中心はデータの保全にあった。
02同居人の多いサーバー
hirizo.sakura.ne.jp

/home/hirizo/
└── www/
    ├── j568/        ← 重五郎屋
    ├── takemaru/    ← 武丸(当時はWordPress)
    └── その他の既存サイト・古いCGIなど
同じサーバーには、今回の対象ではないサイトや古いCGIも動いていた。このため、最初に次の制約を決めた。
- サーバー全体のPHPバージョンや設定を変更しない
- 稼働中のほかのサイトには触れない
- MySQLとWordPressの既存データを削除しない
- 本番に切り替える前に、別のディレクトリで動作を確認する
- 問題が起きたら短時間で元に戻せる構成にする
- 秘密情報はDocumentRootの外に置く
もう一つのサーバー、Xserverで運用している nakagi.jp(この記事を載せているサイト)は、今回の作業とは別の環境である。
03重五郎屋――AmebloをCMSにするAmeblo RSS → PHP → JSON → 静的HTML
重五郎屋では、WordPressもデータベースも新しく導入しなかった。公開側はHTML・CSS・JavaScriptだけで作り直した。デザインの制作はClaudeが主に担当し、ChatGPTは既存構成の把握、サーバー操作の案内、実機での確認、問題が起きた際の切り分けを担当した。
記事を書く場所は変えない
重五郎屋は、もともとAmeblo(アメブロ)で情報を発信していた。新しいサイトのために別の管理画面を覚えてもらう理由はない。そこで、AmebloのRSSをサーバー側で取得し、ホームページに反映する構成にした。
https://rssblog.ameba.jp/tosen15rou/rss20.xmlAmeblo
│ RSS(rss20.xml)
▼
さくらサーバーのPHP(CRON 毎時5分)
│ XMLを解析してJSONを生成
▼
/home/hirizo/www/j568_data/blog.json
│ JavaScriptで読み込み
▼
重五郎屋の静的HTML(/j568/)取得テストでは、記事10件と、本文・写真のURLを確認した。トップページには最新記事5件を、本文の概要と写真付きで表示している。
技術判断:入力と表示を分ける
記事の入力は使い慣れた外部サービス(Ameblo)のまま、公開サイトは独立した静的HTMLにする。両者をPHP+CRON+JSONでつなぐ。この構成が実際に動いたことが、後の武丸の設計を決めた。
未確認だったこと
Claudeの開発環境からはAmebloへの通信が遮断されていたため、制作時点では実際のRSSを取得できていない。さくらのCLI用PHPのバージョンと拡張機能、stat.ameba.jp の写真をほかのサイトから表示できるかどうかも、本番での初回実行時に確認することにしていた。結果はすべて正常で、本番公開時には最新記事5件・本文の概要・写真の表示を確認している。
磯場の写真をどこまで共有するか
武丸のサイトでも、同じ中木の磯場を案内する。そこで、重五郎屋の磯場写真と航空写真を武丸でも使うことになった。調査すると、単純に共有できない問題が2つ見つかった。
- 重五郎屋の磯の説明文には、重五郎屋だけに当てはまる内容が含まれていた(例:「重五郎屋のお客さんには人気」)。武丸のサイトにそのまま載せると、事実と違う案内になる。
- 全沖磯航空写真
202508_14.jpgには、そうした説明文が画像そのものに書き込まれていた。さらに、重五郎屋の磯場案内20か所にない「山越」「ヒカゲ」も記載されていた。
技術判断:画像は共有、文章は各サイト独自
磯名、エリア分け、文字の入っていない写真は共通にし、/j568/ の既存ファイルを武丸から直接参照する。説明文は各サイトで別々に書く。参照される側の /j568/ のファイルは「削除・改名・移動禁止」として依存関係を一覧化し、共通フォルダへの移動は行わない(元のURLを変えないため)。
本番切り替えで起きたこと
完成した静的サイトは別のディレクトリで確認したうえで、/j568/ に反映した。この時、サーバーに古い版の index.html が残っていたために、新しい表示が反映されない問題が起きた。サーバー上のファイルの版を確認し、最新版で上書きして解決している。
記録不足
RSSを解析するPHPの実装(本文の抜き出し方、写真URLの扱い、エラー時の挙動)と、本番公開の正確な日付は、この記録の元資料に残っていない。推測で補わず、追加の資料が見つかり次第追記する。
04武丸――WordPressをやめるという判断
武丸でも最初は、WordPressのまま見た目を改善する選択肢があった。しかし、更新の主体はすでにInstagramに移っていた。WordPressに残っていた役割は、過去記事の保管と、既存ページの表示だけだった。
データベースを調べると、もう一つ分かったことがある。「以前、知人がInstagramとの連携を設定したらしい」と伝えられていた仕組みの実体である。
| DBに残っていた記録 | 推定される仕組み |
|---|---|
| Jetpackによる外部SNSへの共有記録:764件 | WordPress → SNS への自動共有 |
| Facebookから取り込まれた記事:約560件(2018〜2019年) | Facebook → WordPress への取り込み(すでに停止) |
考察
どちらも「Instagram → WordPress」の連携ではなかった。そのため、WordPressを廃止しても、奥さんがInstagramに直接投稿している今の運用には影響しないと判断した。どのSNSと接続していたかはWordPress.com側に記録されるため、データベースからは判別できていない。
WordPressを維持すれば、古いPHPとMySQL、テーマ、プラグイン、管理画面の保守が続く。静的化すれば、公開部分の動的な処理を大きく減らせる。最終的に、次のように役割を分けた。
過去の釣果記事    → WordPressから静的HTMLへ変換
新しい釣果投稿    → Instagramを入力元にする
Webサイトの表示   → HTML / CSS / JavaScript
データの更新      → PHP / CRON / JSON
これはデザインの刷新ではなく、更新方式そのものの変更である。ただし、WordPressの廃止は「過去記事の静的化が合格基準をすべて満たした場合に限る」という条件を付けた。
051,326件の過去記事を静的HTMLにする
旧WordPressのデータベース(SnapUPで取得した snapshot/db.sql、約8.4MB)を、作業環境で読み取り専用で解析し、公開記事を抽出した。
| 対象 | 件数 |
|---|---|
| 公開記事 | 1,326 |
| ユニークな記事URL | 1,323(同じURLに重なる3件は統合) |
| メディア添付のDBエントリー | 2,043 |
| 下書き(公開対象外) | 79 |
| 本文からの画像参照 | 6,829 |
固定ページ5件の内容は、新しいトップページに統合した。静的化では、記事本文を書き出すだけでは足りない。WordPressが暗黙に引き受けていた次の互換性を、すべて静的サイト側で引き継ぐ必要があった。
| WordPressの機能 | 静的サイトでの代替 |
|---|---|
パーマリンク /YYYY/MM/DD/slug/ | 同じパスにディレクトリと index.html を生成 |
?p=記事ID・?attachment_id=画像ID | archive-assets/idmap.json(記事1,326件・添付2,043件)と、トップのJSによる転送 |
?s=検索語 | search/ ページと search.js・search.json(?q= と ?s= の両方を受け付ける) |
旧スラッグ・固定ページ・フィード・wp-sitemap*.xml | .htaccess の301転送(229ルール) |
| サイトマップ | sitemap-archive.xml(1,324URL) |
画像URL /takemaru/wp-content/uploads/… | URLは変えずに、実ファイルの置き場所だけを変える(11章) |
生成物は、置き場所を示すベースパス(BASE)を切り替えて作れるようにした。テスト用の /takemaru_new/ と、本番用の /takemaru/ である。この設計が、7章の本番用ビルドで効いてくる。
06デザインと「正本」の管理
武丸のデザインコンセプトは「磯釣り専門誌 × 海の迫力」とした。先に作った重五郎屋と似たものにしないことが、明確な条件だった。墨色と濃紺を基調に、朱色を差し色に使い、海・磯・渡船の写真を大きく見せる。
このデザインの制作中に、複数のAIの出力が混在する問題が起きた。ある時点で、手元には次の状態のファイルがそろっていた。
- Claudeが制作した新しいトップページのv1(
index.html・top-assets/top.css・top-assets/top.js) - ChatGPTが、元の写真17枚から高画質の5枚を作り、v1の写真を差し替えた統合ZIP(HTMLは画像の
width・heightだけを修正) - Geminiが作ったコード(旧URLを転送するJSを含む)
筆者が下した判断は、「Claude制作のv1を正本とし、ChatGPTの統合ZIPを現在の正本とする。Geminiのコードは不採用」というものだった。そのうえで、Claudeへの指示は次のように明文化された。
- 正本のv1を基準に、必要な部分だけを修正する。HTML・CSS・JSを大きく書き換えない
- 変更した箇所は、ファイル名と内容を一覧にして報告する
- 作業が終わったら、必ずZIPにまとめてダウンロードできる形にする
- アーカイブに関わる変更は、アーカイブとの動作を照合してから報告する
教訓
AIにソースの全文を書き直させると、頼んでいない箇所まで変わる。これを防ぐ運用として、「正本のZIPを1つに決める」「変更は差分だけ」「納品はZIP」「サーバー上で動いた版を最も重く扱う」というルールを固めた。
正本ZIPの監査で見つかったもの
Claudeは作業の前に、正本ZIPの中身(5,272ファイル)を機械的に照合した。ファイル数の内訳と、写真の実寸とHTMLの width・height の一致は確認できた。そのうえで、次の4点が見つかった。
| # | 見つかったもの | 影響 |
|---|---|---|
| 1 | 画像の存在を確認する _check/uploads_check.php がZIPに含まれていない | 旧画像6,829件の存在をサーバー上で確認できない |
| 2 | 全5,272ファイルの権限が 600 | ローカルで展開してから転送すると、Webサーバーが読めずに403になる可能性がある |
| 3 | robots-preview-note.txt(中身は Disallow: /takemaru_new/) | サブディレクトリに置いても効果がない。仮に効いた場合、クローラーが noindex を読めなくなり、逆効果になる |
| 4 | 区切り写真 sea-band.jpg の右下の端に、人物の頭が写り込んでいる | PCの横長表示では切れずに見える。「乗客が写っている写真は使わない」というルールに触れる可能性 |
4は、デザインを確定扱いとしていたため修正せずに報告だけを行い、判断は筆者に委ねた。
07本番用ビルドと検証
テスト用の生成物は、すべての絶対パスが /takemaru_new を指している。本番用に変換するには、これを /takemaru に置き換えればよい。その前に、置換して問題がないかを確かめた。
"takemaru_new" の出現数      : 245,102
"/takemaru_new" の出現数     : 242,455
"https://nakagi.net/takemaru_new" : 2,647
→ 242,455 + 2,647 = 245,102(すべてスラッシュ付きのパスとして出現)
すべての出現がパスとして使われていることを確認してから、置換した。結果は5,257ファイル、245,101か所。数が1つ合わないのは、本番用ビルドから除外した robots-preview-note.txt の中の1か所である。
.htaccess には、次の3点の変更を加えた。
- 転送ルールの
/takemaru_new/を/takemaru/に置換 - テスト用に入れていた
Header always set X-Robots-Tag "noindex, nofollow"を削除 - 旧画像を
/takemaru_wp/から配信する3行を追加(11章)
# 武丸 釣果アーカイブ  本番用(BASE=/takemaru)
AddDefaultCharset UTF-8
DirectoryIndex index.html
Options -Indexes
<IfModule mod_rewrite.c>
RewriteEngine On
RewriteBase /takemaru/
# 旧WordPressの画像:/takemaru_wp/ へ退避した uploads を同じURLで配信(URLは変えない)
RewriteCond %{REQUEST_FILENAME} !-f
RewriteRule ^wp-content/uploads/(.*)$ /takemaru_wp/wp-content/uploads/$1 [L]
RewriteRule ^welcome/?$ /takemaru/#greeting [R=301,NE,L]
RewriteRule ^services/?$ /takemaru/#service [R=301,NE,L]旧WordPressのクエリ形式のURLは、.htaccess ではなくトップページのJSで転送することにした。1,326件分の RewriteCond %{QUERY_STRING} を並べると、.htaccess が肥大化するためである。
// 旧WordPressのクエリURL(?p= ?attachment_id= ?s=)を静的ページへ転送
(function () {
  'use strict';
  if (!window.URLSearchParams) return;
  var q = new URLSearchParams(location.search);
  var dir = location.pathname.replace(/[^\/]*$/, '');   // 例:/takemaru/
  var base = dir.replace(/\/$/, '');
  if (q.has('s')) { location.replace(dir + 'search/?q=' + encodeURIComponent(q.get('s'))); return; }
  var p = q.get('p'), a = q.get('attachment_id'), id, keys;
  if (/^\d+$/.test(p || '')) { id = p; keys = ['p', 'a']; }
  else if (/^\d+$/.test(a || '')) { id = a; keys = ['a', 'p']; }
  else return;
  fetch(dir + 'archive-assets/idmap.json').then(function (r) { return r.json(); }).then(function (m) {
    for (var i = 0; i < keys.length; i++) {
      var u = m[keys[i]] && m[keys[i]][id];
      if (u) { location.replace(base + encodeURI(u)); return; }
    }
  }).catch(function () {});
})();
Apacheで本番の構成を再現して検証
Claudeの作業環境にApache 2.4を入れ、/takemaru/(新しいサイト)と /takemaru_wp/(旧WordPress。.htaccess と参照画像のダミー6,829件だけ)を並べて、本番の切り替え後の状態を再現した。
| 検証項目 | 結果 |
|---|---|
| 全5,256ページの内部リンク・画像・CSS・JS(ユニーク8,742URL) | すべて200、または301の転送先が200 |
idmap.json の転送先3,369件/検索データ1,326件/サイトマップ1,324件 | 全件200 |
.htaccess の転送ルール229件 | 全件、正しい転送先に301 |
?p=4887・?attachment_id=510・親記事のない添付 ?attachment_id=116・?s=真鯛 | すべて正しいページへ転送。存在しないIDではトップのまま |
| 旧画像URL(存在するもの/しないもの) | 200(/takemaru_wp/ の実ファイル)/404 |
X-Robots-Tag | 本番用では出力されない |
画像の存在確認には、鍵による認証を付けた確認用PHPを別のフォルダで用意した。このPHPは読み取り専用で、鍵がない場合は404を返す。参照画像6,829件の存在とサイズが0バイトでないことを調べるほか、manifest.tsv(5,270ファイルのパスとサイズ)と照合して、アップロード漏れやサイズの違いを検出する。リスト類(.txt・.tsv)は .htaccess で外部から読めないようにした。
085,270ファイルをどう運ぶか
テスト公開では、ZIPを転送し、サーバー上でPHPを使って展開する方式を使った。この展開用PHPにはChatGPTがコードレビューを行い、次の不足が指摘されて修正している。
- 第三者がURLにアクセスして実行できないよう、認証を追加する
- ZIP内の全エントリーを展開前に検査し、
../、絶対パス、想定外のフォルダ、シンボリックリンクなどを拒否する - 展開先を
takemaru_new/以下に限定する - 展開前に、ZIPの展開後の総サイズとサーバーの空き容量を確認する
- 失敗した場合はPHPを自動削除せず、原因を確認できるようにする
本番への移行では、Claudeの手順書はFFFTPによるフォルダごとのアップロードを案内していた。展開用PHPを公開領域に置かずに済むためである。しかし実際には、大量の個別転送の途中でアップロードエラーが起きた。そこで個別の転送を中止し、ZIPを一括で展開する方式に切り替えた。本番用に展開されたファイルは5,270件である。
考察
小さなファイルを数千個FTPで個別に送る方法と、1つのアーカイブを送ってサーバー側で展開する方法では、実際の運用での負担が大きく違う。一方で、サーバー上で動く展開用PHPは、それ自体が新たな攻撃面になる。認証、対象ZIPの限定、展開先の限定を行い、使い終わったらすぐに削除する、という運用で両立させた。
09Meta Graph APIとの格闘
武丸では、奥さんがInstagramに投稿すると、Facebookページにも自動で共有される運用がすでにできあがっていた。目標は、この投稿の流れを一切変えずに、ホームページを3つめの表示先として加えることだった。
奥さんがInstagramへ投稿
       │
       ├── Facebookページへ自動共有(Metaの標準機能)
       │
       └── Instagram Graph API
                 │
                 ▼
          さくらサーバー(PHP+CRON)
                 │
                 ▼
          武丸ホームページ
設計段階の想定と、実際にたどった道
設計段階でClaudeが推奨していたのは、Facebookページを経由しない「Instagram API with Instagram Login」型だった(接続先 graph.instagram.com、権限は instagram_business_basic のみ、60日間有効の長期トークンを refresh_access_token で自動更新する)。Facebook Login型は「Facebook側の状態に左右される」として、不採用にしていた。
実際には、まったく逆の経路で開通することになった。
管理単位の迷路
Meta for Developersで、アプリ Takemaru Catch Feed を作成した。しかしMetaの開発環境には、次の管理単位が重なっている。
- 個人のFacebookアカウント
- Meta開発者アカウント
- ビジネスポートフォリオ
- Facebookページ
- Instagramプロアカウント
- 開発アプリ
- アプリに付与するアクセス許可
武丸のビジネスポートフォリオは、奥さんが管理していた。筆者は自分のFacebookアカウントを、そのポートフォリオに招待してもらった。しかし、招待されただけでは開発アプリとの関連付けはすぐには完了しなかった。さらに、Metaの新しいUnified Login側では既存のビジネスポートフォリオを選択できず、新しいポートフォリオを作る画面へ進んでしまった。
人間の判断:不要なポートフォリオは作らない
画面の流れに従って新しいビジネスポートフォリオを作れば先へ進める。しかし、管理の単位が増えて将来の混乱のもとになる。筆者はこれを作らないと判断し、接続方法そのものを見直した。選んだのは、すでにFacebookページと連携しているInstagramアカウントを、Facebook Login型のGraph APIから取得する経路だった。
API権限と実データ
Graph API Explorerで使った権限は次の3つで、Facebookログインの認証画面で、対象のFacebookページとInstagramアカウントだけを選んだ。
instagram_basic
pages_show_list
pages_read_engagementFacebook Page ID: 2095641747334370
Instagram Business Account ID: 17841406985745841まず、FacebookページとInstagramアカウントが紐付いていることを直接確認した。
GET /2095641747334370
?fields=id,name,instagram_business_accountGET /17841406985745841/media
?fields=id,caption,media_type,media_url,permalink,timestamp
&limit=3ここで、投稿ID、本文、写真URL、投稿へのリンク、日時が返ってきた。
教訓
認証画面に「成功」と表示されることと、目的のAPIレスポンスが返ってくることは別の問題である。設定の画面ではなく、実際のレスポンスで判断する。
トークンの寿命
Graph API Explorerが最初に発行したのは、短期のUser Access Tokenだった。その後、Page Access Tokenも取得できたが、有効期限は約1時間しかなく、CRONでの長期運用には使えない。そこでAccess Token Debuggerを使い、次の順序で確認を進めた。
- 短期のUser Tokenを確認する
- User Tokenを延長する
- 長期のUser Tokenを発行する(Debugger上の有効期限:2027年1月4日)
- 長期のUser TokenからPage Tokenを取得する
- そのPage Tokenで、Instagramの投稿取得を再試験する
- Debuggerでトークンの種類と有効期限を確認する → 有効期限「なし」
考察
有効期限の指定がないことは、失効しないことを意味しない。権限の変更、接続の解除、Meta側の仕様変更、データアクセスの条件などで、再認証が必要になる可能性は残る。設計段階で想定していた「60日ごとの自動更新」の仕組みは、結果として必要なくなった。代わりに、失効を検知する仕組みが課題として残った(15章)。
10fetch.php――毎時23分のパイプライン
/home/hirizo/
├── ig_takemaru/          ← DocumentRootの外
│   ├── config.php        ← トークン(権限600)
│   ├── fetch.php
│   ├── fetch.log
│   └── fetch.lock
└── www/
    ├── takemaru/
    └── takemaru_data/
        ├── ig.json
        └── ig/            ← 保存した写真
config.php.php 事件
最初の設置で、Windows側の拡張子の扱いを誤り、config.php.php という名前でアップロードされた。FFFTPの一覧で気づき、config.php に直している。小さなミスだが、設定ファイルを require する構造では、これだけで全体が動かなくなる。
fetch.phpの設計
ChatGPTとの作業で作られた fetch.php の要点を、実ファイルから抜粋する(トークンは config.php から読み込むため、ここには含まれない)。
<?php
/** 武丸 Instagram read-only synchronizer; PHP 7.4+, CLI only. */
if (PHP_SAPI !== 'cli') { http_response_code(403); exit; }try {
// Auth only to Graph API, via request header (not logged in URLs).
$endpoint = 'https://graph.facebook.com/v27.0/' . $igId . '/media?fields=id,caption,media_type,media_url,thumbnail_url,permalink,timestamp&limit=12';
$ch = curl_init($endpoint);
$body = '';
curl_setopt_array($ch, [CURLOPT_RETURNTRANSFER=>false, CURLOPT_FOLLOWLOCATION=>false, CURLOPT_CONNECTTIMEOUT=>12, CURLOPT_TIMEOUT=>40,
CURLOPT_SSL_VERIFYPEER=>true, CURLOPT_SSL_VERIFYHOST=>2, CURLOPT_HTTPHEADER=>['Authorization: Bearer '.$cfg['page_token']],このほかに、画像の取得先を cdninstagram.com・fbcdn.net に限定し、リダイレクトを追わず、受け取るサイズに上限を設けている。写真はGDで長辺1600pxに縮小し、JPEG品質85で保存する。
        // Preserve aspect ratio, cap longest side at 1600 px
        $scale = min(1,1600/max($w,$h));
        $res = imagecreatetruecolor(max(1,(int)round($w*$scale)),max(1,(int)round($h*$scale)));
$white = imagecolorallocate($res,255,255,255); imagefill($res,0,0,$white); if (!$items) throw new RuntimeException('No valid posts; existing feed preserved');
usort($items, function($a,$b){return strcmp($b['timestamp'],$a['timestamp']);});
$json=json_encode(['items'=>$items],JSON_PRETTY_PRINT|JSON_UNESCAPED_UNICODE|JSON_UNESCAPED_SLASHES|JSON_INVALID_UTF8_SUBSTITUTE);
if ($json===false) throw new RuntimeException('JSON encode failed');
save_atomic($outRoot.'/ig.json',$json);
echo 'OK: '.count($items)." posts saved\n";観察
Claudeが受け取った fetch.php は、CRLF改行だった。サーバー上の原本の改行コードは確認していない。序章の110バイト問題と同じく、転送の経路で変換された可能性がある。
「ログが0バイト」をどう読むか
/usr/local/bin/php /home/hirizo/ig_takemaru/fetch.php >> /home/hirizo/ig_takemaru/fetch.log 2>&12026年11月5日23時23分の初回実行の後、fetch.log と fetch.lock ができていた。ただし fetch.log は0バイトだった。その時点では成功と断定せず、出力のほうを順に確かめた。
/home/hirizo/www/takemaru_data/ig.json   8,242 bytes
/home/hirizo/www/takemaru_data/ig/ 12 files最後にトップページで実際の釣果が表示されることを確認し、Graph API → PHP → 画像保存 → JSON生成 → JavaScriptで描画 という一連の流れが動いていることを検証した。
考察
fetch.php は成功時に OK: N posts saved を標準出力に出す実装になっている。それでもログが0バイトだった理由は、記録からは確定できない(記録不足)。なお、後から作った archive.php は、毎回の実行で日時と件数を1行ずつログに出す設計にしてある。
11本番切り替え――名前を2回変えるだけ
本番への移行では、旧WordPressを削除も移動もせず、フォルダ名の変更だけで切り替えた。
変更前:
www/
├── takemaru/       ← 旧WordPress(公開中)
├── takemaru_new/   ← テスト用
└── takemaru_next/  ← 本番用(BASE=/takemaru でビルド)

変更後:
www/
├── takemaru/       ← 新しい静的サイト
├── takemaru_wp/    ← 旧WordPress(そのまま保管)
└── takemaru_new/ ← テスト用takemaru → takemaru_wp
takemaru_next → takemaru元に戻すときは、名前を逆の順に変えるだけでよい。旧WordPressの .htaccess、wp-config.php、データベースには、切り替えの間も一切触れていない。
注意
旧WordPressの絶対URLやデータベースの設定(siteurl など)は /takemaru/ のままである。takemaru_wp の名前のままでWordPressとして動かすことは想定していない。元に戻すときは、必ず元の名前に戻す。
6,829件の画像参照を守る
過去記事のHTMLには、旧WordPressの画像パス /takemaru/wp-content/uploads/YYYY/MM/... がそのまま残っている。WordPressを takemaru_wp に移すと、画像の実体もそちらへ移る。HTMLを大量に書き換える方法も、画像をコピーする方法も取らなかった。新しい /takemaru/.htaccess に、7章で示した3行を加えただけである。
RewriteCond %{REQUEST_FILENAME} !-f
RewriteRule ^wp-content/uploads/(.*)$ /takemaru_wp/wp-content/uploads/$1 [L]
このリライトは内部で処理されるため、ブラウザから見えるURLは変わらない。リライト後のリクエストは /takemaru_wp/ 側の .htaccess(WordPressの標準ルール)でも処理されるが、実在するファイルに対しては条件 !-f が成立しないため、そのまま配信される。この方式なら、/j568/ など他のサイトが武丸の画像を参照していても、同じURLのまま表示される。
画像参照            :6,829件
見つかった画像      :6,829件
見つからない画像    :0件
0バイトの画像       :0件

本番用ファイル      :5,270件
不一致              :0件
.htaccessの検査     :OK
技術判断
既存URLとの互換性を保ったまま、過去の画像を重複してコピーしない。将来WordPressを完全に撤去する際は、先に wp-content/uploads/ を /takemaru/ 側に移し、リライトの3行を外す。
12公開後の3つの改修
公開後すぐに、3つの改修を依頼した。いずれも、完成したデザインを維持したまま機能だけを足すことが条件だった。
月ごとの出船時間を自動で表示する
| 月 | 出船 |
|---|---|
| 1・2・11・12月 | 6:30 |
| 3〜5・10月 | 6:00 |
| 6・9月 | 5:30 |
| 7・8月 | 5:00 |
要件は「日本時間を基準にし、閲覧者の端末のタイムゾーンに左右されない」「JavaScriptが無効でも、誤った時刻を表示し続けない」の2つ。Claudeは Intl を使わず、日本に夏時間がないことを利用して、UTCに9時間(324e5 ミリ秒)を足す計算にした。時刻のデータはHTMLの属性に持たせ、要点欄の直後に置いたインラインスクリプトで書き換えている。
<div><dt>出船</dt><dd data-dep="6:30,6:30,6:00,6:00,6:00,5:30,5:00,5:00,5:30,6:00,6:30,6:30"><b>月別</b><small><a href="#service">5:00〜6:30(月ごとの出船時間)</a></small></dd></div><script>/* 出船時間:日本時間の月で表示(JS無効時は月別の案内のまま) */(function(){var d=document.querySelector('[data-dep]');if(!d)return;var t=d.getAttribute('data-dep').split(','),m=new Date(Date.now()+324e5).getUTCMonth();if(t.length!==12||!/^\d{1,2}:\d{2}$/.test(t[m]))return;d.querySelector('b').textContent=t[m];d.querySelector('small').textContent=(m+1)+'月の出船時間';})();</script>検証では、ブラウザのタイムゾーンをロサンゼルスに設定し、日本時間での月の変わり目を含む6つの時点で表示を確かめた。たとえば日本時間の2月28日23時59分は「6:30/2月」、3月1日0時0分は「6:00/3月」と表示される。
依頼の範囲外で変更したこと
要点欄だけを月別にすると、下の出船時間表の「夏季 5:30」と食い違う。そこで、出船時間表も月別の4行に直し、今月の行を朱色で示すようにした。この変更は報告書に明記している。
Googleマップを自動で表示する
それまでの地図は、表示速度とプライバシーを優先して「タップすると読み込む」方式だった。これを、地図の600px手前までスクロールした時点で、IntersectionObserverでiframeを差し込む方式に変えた。プレースホルダーは <button> からGoogleマップへのリンク(<a>)に変えたので、JSが無効な場合や、30秒以内に読み込みが終わらない場合でも地図を開ける。
    if ('IntersectionObserver' in window) {
      var mo = new IntersectionObserver(function (es) {
        for (var i = 0; i < es.length; i++) if (es[i].isIntersecting) { mo.disconnect(); loadMap(); return; }
      }, { rootMargin: '600px 0px' });
      mo.observe(map);
    } else loadMap();
  }
Instagram釣果のページ送り――なぜ9件と12件なのか
依頼は「1ページ12件程度」だった。しかし、既存の最新釣果グリッドには、先頭の1枚を大きく見せる設計がある。グリッドが何マスを使うかは、画面の幅によって変わる。
| 画面の幅 | 列数 | 先頭の1枚 | n件で使うマス数 | 隙間なく並ぶ条件 |
|---|---|---|---|---|
| 700px未満 | 2 | 2列分 | n + 1 | nが奇数 |
| 700〜999px | 3 | 1マス | n | nが3の倍数 |
| 1000px以上 | 4 | 2×2 | n + 3 | n + 3が4の倍数 |
3つの条件を同時に満たす件数は、n ≡ 9(mod 12)、つまり9件、21件、33件……である。12件にすると、PCでは最後の行に1マス、スマホでも1マスの空きが出る。元の設定の9件は、この3つの条件を同時に満たす最小の数だった。
技術判断
1ページ目は従来どおり、大きな1枚つきの9件。2ページ目以降は、先頭を大きくする指定を外した均等なグリッドで12件ずつにする(12はどの列数でも割り切れる)。件数を統一するより、写真のグリッドの完成度を優先した。
ページ番号はURLに ?igp=N として残す。history.pushState と popstate を使い、ブラウザの戻る・進む、再読み込み、範囲外の数字、不正な値でも破綻しないことを確認した。ボタンの高さは44pxで、375px以上の幅では1行に収まる。
この改修の途中で、別の不具合も見つかった。投稿日の表示が、APIの返すUTCの日付をそのまま使っていたのである。日本時間で午前9時より前の投稿は、前日の日付で表示されていた。これも日本時間で表示するように直した。
13archive.php――過去を少しずつ遡る
最新の釣果がトップに出るようになっても、それだけでは不十分だった。過去1,326件のWordPress記事を静的化して残したのに、Instagramに移ってからの釣果は、最新の12件より前が見られない。釣果の記録が途中で途切れてしまう。
技術判断:稼働中の fetch.php には触れない
過去分の取得は、新しく作る archive.php と、もう1つのCRON(毎時33分)に分けた。過去の大量取得が失敗しても、最新の釣果の表示は止まらない。archive.php が止まった場合でも、トップページは ig.json だけで従来どおり動く。
fetch.php(毎時23分)  … 最新12件を取得 → ig.json(変更なし)
archive.php(毎時33分)… ① ig.json を取り込む(APIは使わない)
                          ② 過去分をAPIのページ送りで遡る(完了するまで)
                          ③ ページ単位の公開用JSONを作る
取り込みと遡り
新しい投稿は、fetch.php が書き出した ig.json から取り込む。写真のファイル名 /takemaru_data/ig/{投稿ID}.jpg から投稿IDを取り出し、それをキーにして archive.json(公開領域の外)に追加・更新する。削除はしない。
    // 1) ig.json(fetch.php の成果)を取り込む。APIは使わない
    $feed = @json_decode((string)@file_get_contents(IGA_WWW_DATA . '/ig.json'), true);
    $fromFeed = 0;
過去分は、Graph APIの /{IG-ID}/media を after カーソルで遡る。進んだ位置は archive_state.json に、1ページ処理するごとに保存する。レスポンスの paging.next にはトークンを含むURLが入ることがあるため、これは使わず、カーソルだけを使って自前でURLを組み立てる。
        while (empty($state['done']) && $pages < IGA_PAGES_PER_RUN && (time() - $t0) < IGA_MAX_SECONDS) {
            $q = IGA_IG_ID . '/media?fields=' . rawurlencode($fields) . '&limit=' . IGA_API_LIMIT;
if (!empty($state['after'])) $q .= '&after=' . rawurlencode($state['after']);define('IGA_PER_FIRST', 9); // 1ページ目の件数(トップの大きな1枚つきグリッド)
define('IGA_PER_PAGE', 12); // 2ページ目以降の件数
define('IGA_API_LIMIT', 25); // APIの1回あたりの件数
define('IGA_PAGES_PER_RUN', 4); // 1回の実行で遡るAPIページ数(最大100件)
define('IGA_MAX_SECONDS', 240); // 1回の実行で過去分の取得に使う最大秒数
define('IGA_RETRY_MAX', 3); // 再試行の上限回数
define('IGA_KEEP_VERSIONS', 3); // 公開用の版をいくつ残すか(現行を含む)公開用JSONを壊さずに差し替える
ページを移動中の閲覧者が、新しい index.json と古いページのファイルを組み合わせて読んでしまうと、表示が崩れる。これを防ぐため、毎回新しい版のフォルダ(v年月日時分秒)に全ページを書き出し、最後に目次の index.json を差し替える。古い版は3つまで残す。内容に変化がなければ、何も書き出さない。
        do { $ver = 'v' . date('YmdHis'); $vdir = $pubDir . '/' . $ver; if (is_dir($vdir)) sleep(1); } while (is_dir($vdir));
        if (!mkdir($vdir, 0755)) throw new RuntimeException('Cannot create ' . $ver);
        $chunks = array(array_slice($pub, 0, IGA_PER_FIRST));
        for ($i = IGA_PER_FIRST; $i < $total; $i += IGA_PER_PAGE) $chunks[] = array_slice($pub, $i, IGA_PER_PAGE);
        foreach ($chunks as $i => $c) save_atomic($vdir . '/p' . ($i + 1) . '.json', json_out(array('page' => $i + 1, 'items' => $c)));
save_atomic($pubDir . '/index.json', json_out(array('ver' => $ver, 'total' => $total, 'pages' => count($chunks),/home/hirizo/www/takemaru_data/ig_archive/
├── index.json ← {"ver":"v…","total":…,"pages":…,"per_first":9,"per_page":12}
├── v20261106…/p1.json, p2.json, …
└── (古い版を最大2つ残す)模擬APIでの検証
本物のAPIには作業環境から接続できないため、Pythonで模擬のGraph APIを作り、140件の投稿を用意した。このデータには、動画、media_url のない複数枚の投稿、画像のない動画、一覧のURLでは画像の取得に失敗する投稿を混ぜている。
| シナリオ | 結果 |
|---|---|
| 初回の実行 | ig.json の12件と、API4回分の88件で、計100件。重複なし |
| 途中でHTTP 500 | ログに記録して、保存済みのデータを維持。次の実行で同じ位置から再開 |
トークンの失効(code 190)/config.php がない | 保存済みのデータと公開データを維持。ig.json の取り込みと公開は継続 |
archive.json の破損 | 上書きせずに中止 |
| 同時に実行 | 2つ目は Already running で終了 |
| 画像の取得失敗 | 投稿単体を取得し直して回復。画像がない投稿は3回で打ち切り(SKIP) |
| トークンの漏えい | URL、ログ、archive.json、公開JSONのいずれにも含まれない |
本番での初回
本番での初回実行では、100件の蓄積と、全9ページの表示が確認された。ブラウザで2ページ目に移動し、過去の写真と本文が表示されることも確認している。
考察:100件と9ページという数字
どちらも設計から計算できる値と一致する。初回の実行では、ig.json の12件と、APIの4回×25件を取り込む。APIは新しい順に返すので、最初の12件は ig.json と重複し、合計は100件になる。ページ数は、1ページ目が9件、残りの91件を12件ずつに分けると8ページなので、合計9ページ。本番のログの数値は、この記録には残っていない。
未確認
Instagramの全投稿(調査時点で1,339件)の取得完了は、この記録の時点では確認できていない。1回の実行で最大100件を遡る設計なので、約14回の実行で完了する見込みである。
14二つのAIと人間
| 主な担当 | |
|---|---|
| Claude | HTML・CSSの設計、写真を中心にしたUIデザイン、旧WordPress記事の静的化、データ変換と構造の検証、本番用ビルド、差分ZIPの制作、本番移行と差分反映の手順書 |
| ChatGPT | 技術構成の相談、Meta Graph APIの設定支援、Graph API Explorerでの取得検証、fetch.php の制作、サーバー操作の案内、FFFTP・CRONの設定、本番での動作確認、Claudeへの引き継ぎ資料の作成、展開用PHPのコードレビュー、写真の高画質化と統合 |
| 筆者 | 正本の決定、デザインの採用、Instagramの管理者(奥さん)との調整、権限設定の承認、サーバー上の配置の確認、APIレスポンスの検証、フォルダ名の変更、本番公開の判断、PCとスマートフォンでの実機確認 |
この分担は固定されたものではなく、ファイルの統合やコードの検証など、担当が重なる場面も多かった。
AI同士は、状態を自動では共有しない
開発の途中で、Claudeは「Instagram連携はまだ実装されていない」という前提で作業計画を出していた。正本ZIPの材料チェックに答えた際、作業の順序の最後にこう書いている。
| 7 Instagram API連携 | 後回しにできる | 依頼者側でのトークン発行が先に必要 |しかし、その時点でChatGPT側では、Metaの認証、PHP、CRON、写真の保存、トップページでの表示まで、すでに成功していた。AI同士は作業の状態を自動では共有しないため、Claudeは手元の資料にある古い状態を前提にしていた。この食い違いは、ChatGPT側の成果をまとめた次の引き継ぎ資料で訂正された。
逆の方向の誤りもあり得た。AIが作業途中の古いZIPを正本と思い込んだり、別の版のファイルを前提に修正を進めたりする危険である。これに対する備えとして、差分を反映する手順には必ず「サーバー上のファイルのサイズが想定どおりか」を確認する手順を最初に入れた。序章の110バイトの食い違いが見つかったのも、この確認の過程だった。
原則
実際に動いている本番環境が、最終的な事実である。AIの説明や資料は、それに照らして検証しなければならない。
人間に残った仕事
AIにすべてを任せたわけではない。新しいビジネスポートフォリオを作らなかった判断、Geminiのコードを捨てた判断、正本を決めた判断、公開のタイミング、そして実機での確認は、すべて人間が行った。AIの提案が実際の状況と食い違ったときに、それを指摘して直させたのも人間である。今回の開発は、AIが単独でサイトを完成させた事例ではない。AIが制作と分析を担当し、人間が環境と現実の状態を管理した共同開発だった。
15完成時点の構成と残された課題
Instagram(takemaru.nakagi)
     │
     ├── Metaの標準機能 ──→ Facebookページ
     │
     └── Instagram Graph API(graph.facebook.com/v27.0)
               │
               ▼
/home/hirizo/ig_takemaru/          ← DocumentRootの外
     ├── config.php      認証情報(権限600)
     ├── fetch.php       毎時23分:最新12件
     ├── archive.php     毎時33分:取り込み・遡り・公開
     ├── archive.json    全投稿の保存データ
     └── archive_state.json
               │
               ▼
/home/hirizo/www/takemaru_data/
     ├── ig.json
     ├── ig/{投稿ID}.jpg
     └── ig_archive/index.json, v…/p{N}.json
               │
               ▼
/home/hirizo/www/takemaru/
     ├── index.html, top-assets/
     ├── 過去記事HTML(1,326件), archive-assets/, search/
     └── .htaccess(転送229件+uploadsの内部リライト)
               │
               ▼
閲覧者のブラウザ

/home/hirizo/www/takemaru_wp/ 旧WordPress(画像の配信元として稼働中)| 分類 | 残っている課題 |
|---|---|
| Instagramの認証 | Page Access Tokenが今後も有効か。権限の変更やデータアクセスの期限への対応、失効したときの再発行手順の文書化 |
| アーカイブ | 全投稿の取得完了の確認。初回の大量取得後も継続して動くかの確認。画像容量の増加(1枚0.2〜0.5MB、全件で約300〜650MBと推定)。Instagramで削除した投稿は残る仕様 |
| バックアップ | 静的HTML、takemaru_data、ig_takemaru の定期的なバックアップ。認証情報を安全な場所に別途保管。サーバー障害時の復旧手順 |
| セキュリティ | 展開用PHPと確認用PHPを削除したことの確認。/takemaru_wp/ のPHP(wp-login.php・xmlrpc.php など)が今も外部から実行できる状態への対策。ただし、画像の配信元なのでフォルダごとは消せない |
| 監視 | CRONが失敗したことを検知する仕組み(現状はログを見に行く必要がある) |
| 写真 | sea-band.jpg の写り込みの扱い(未決定) |
考察
本番で表示に成功していることと、長期的に保守が要らないことは同じではない。
終レガシー環境を壊さず再構築するという仕事
2つのサイトに共通するのは、最新の技術に置き換えること自体を目的にしなかった点である。重五郎屋ではAmebloを、武丸ではInstagramを投稿元にした。どちらも公開側は静的HTMLとし、外部サービスとの接続をPHPとCRONに任せた。毎日投稿する人は使い慣れたサービスをそのまま使い続け、公開サイトは独自のデザインを持ち、過去の情報を保ち、将来も拡張できる。
AIの出力は、いつも正しかったわけではない。古いファイルを前提にしたことも、権限の仕組みを読み違えたことも、完了済みの工程を未完了だと思い込んだこともあった。設計段階で推奨したAPIとは逆の経路で開通し、手順書で案内した転送方法は途中で失敗した。それでも、実際のサーバーの状態を確かめ、問題を小さく切り分け、一つずつ直していくことで、システムは完成した。
設計と実装は、AIで大幅に速くできる。しかし、現実のシステムを理解し、壊さずに運用する責任は、人間に残る。